DeepSeekの発表内容
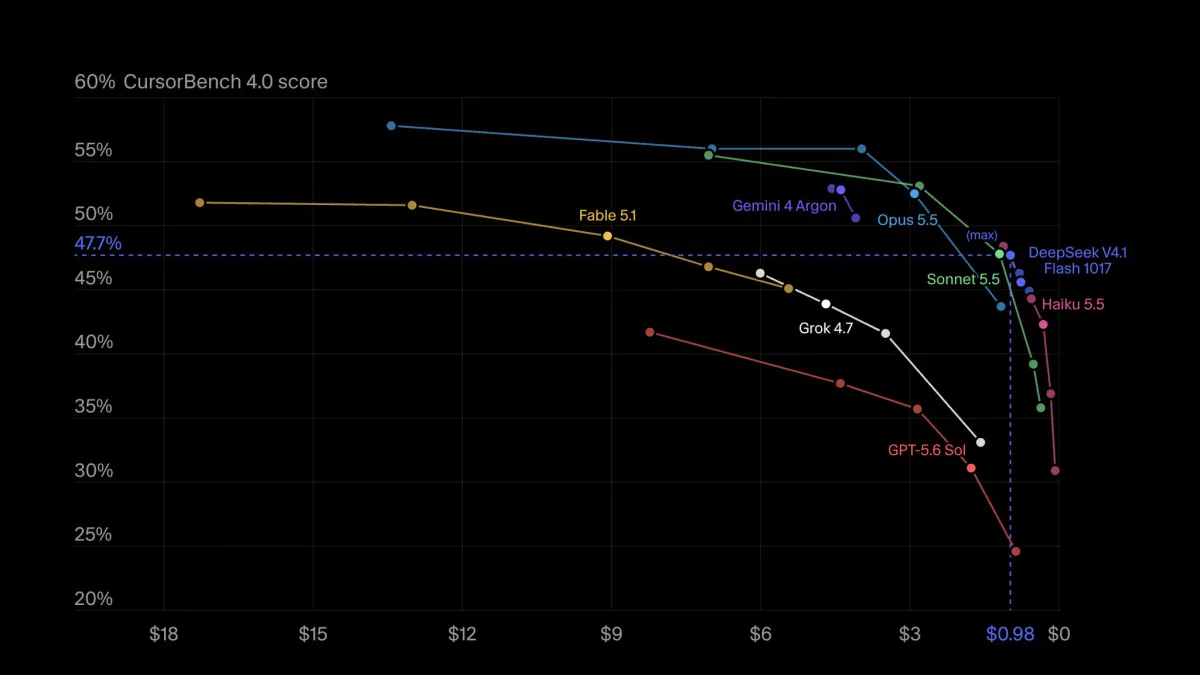
同社はこのモデルを、より賢く、より速く、より効率的なモデルと位置づけています。
「DeepSeek-V4.1-Flash」は、新しい設計方式で作られたモデル群の中で最も小さいモデルです。画像を読み取る力を、モデル本体に最初から備えています。文字だけでなく画像も、同じモデルで扱えます。
同社は設計の狙いとして、能力の向上、推論 (モデルが答えを出すまでの処理) の高速化、処理量の増加を挙げています。加えて、この設計をより大きなモデルへ広げていくことも見据えています。
画像を読む力を最初から持つ小型モデルが加わったことで、画面の写真や紙の資料を画像のまま渡して処理させる選択肢が増えます。軽いモデルで済ませたい作業でも、画像を含む資料を投げられます。
つまり、どういうこと?
つまり、写真やスクリーンショットをそのまま渡して、中身を読ませられるモデルです。しかも同じシリーズの中では一番小さい軽量版になります。たとえるなら、覚えが早くて動きも軽く、そのうえ書類の写真まで読める新人が入ってきたような形です。小さいモデルは動きが軽く、使う側の負担も小さくなります。
誰に関係するか
資料や画面の画像をそのまま AI に読ませたい人は、小さくて速いモデルにその作業を任せられるようになります。
出典: DeepSeek 公式 X ↗